顯示具有 財務 標籤的文章。 顯示所有文章

2017年9月17日 星期日

[R] Tidyquant 的練習-利用200天平均線的測試

最初大約是3-4月,當時參加了一個 R User group的 Machine Learning Beginner 的課堂,接觸到 "tidyverse" library。Tidyverse" 中的 "dplyr" 在數據整理上十分方便,不過課堂中處理的都是一些非時間序列的數據,好奇在時間序列的股票方面有什麼好工具可以使用呢?那時候開始留意到有一個叫 "tidyquant" 的 R Library,就一直想找時候來學習一下。例如,好不好把之前的股價研究換成用 Tidyquant再試一次?終於,上星期在 Feedly 看到一篇評論信報某專欄的blog post,就正好用這研究來作為練習,有興趣的話建議先看以下兩篇原文:

分析數據還是以數據「作」分析呢?
https://htmichael.blogspot.hk/2017/08/blog-post.html

【EJFQ信析】港股未脫超買 不離三種下場
http://www2.hkej.com/instantnews/market/article/1636469


2017年6月16日 星期五

[JS] 用 NodeJS 和 Socket.IO 製作實時更新的自家股價指標查詢網頁

繼續Node.JS 的學習,這篇是要記錄另一個嘗試,在後台的Server不斷更新股價資料和自設的指標,做一個網頁可以讓自己在屋企以外也可以查詢這些後台的資訊。

之前的星期看完了Coursera的那個Node 的課程,內容是充實的,繼之前的內容後,還有HTTP 的session , https, authorise token。 不過未有用到的想法,看完也像過眼雲煙。能夠上心的反而只有自己試的Socket.IO。會這樣做是因為看到一篇Socket.IO 的文章,可以讓客戶端的瀏覽器和伺服器端作實時雙向溝通,不必客戶端去不斷刷新。


2016年10月2日 星期日

[R] 閱後測試-R語言與股票市場的預測

原來上水圖書館的電腦類書有不少我想要的題目,打算去找點數學的書,結果卻捧了一堆電腦程序的書回來。
《巨量資料的第一步-R語言與商業應用》
《實戰Java-9個別具特色的實作經驗》
《Arduino錦囊妙計》
《Raspberry Pi 機器人自造專案》

這本學習R的書,算是我看過的R中文書當中很好的一本,特別是案例的部份的學習價值就很高。基本內容都有提及一些我不熟悉的。例如時間和時間序列的類型、資料連接SQL資料庫、處理遺留數據等。

上月初,周末加班時就帶著電腦和書,在坐車時跟著書去嘗試。誰知把書放在椅背休息一下,落車時就忘了帶走。好在一星期後發現有人已經代為把書還了圖書館,感謝這個好心人。

首先跟著這本書試的是這一章「股票市場的預測」。 它是用quandmod套件中的getSymbols()功能獲得xts時間序列類型的股價資訊。建立一個自行定義的回報觀察值去衡量價格變動,再用常見的技術分析指標作變數,建立決策樹Decision Tree的模型。最後評價模型的預測誤準確度。

2016年6月12日 星期日

[R] 複製-市盈率與後市關係之統計

最近好像少了Coding上的主題。上星期看到這篇文章:《以市盈率和股息率看後市統計》,正好想把這個作為R的練習。它統計在不同市盈率(P/E)之下,恆指在1個月以至1年之後是升還是跌。結論是:雖然恆指無論在高或低市盈率的短期(一個月)後,表現未見有特別;但當看一年或兩年後的話,則明顯升多跌少。而且市盈率越低,一年後及二年後上升的機會越大。

過程

想重複這個統計,需要的兩項資料分別是恆指收市價和恆指市盈率。在練習R時,收市價當然是用它的Library: "quantmod" 。背後的數據來源是Yahoo財經;因為今次需要的是月度資料(之後提到的恆指PE,要方便的話也是拿按月的資料),所以用compression="m";再用"zoo"格式的as.yearmon(index( )) 紀錄這類月度的時間序列。
Prices = get.hist.quote(instrument="^hsi", start="1986-01-01",end="2016-05-31", 
  quote=c("Close","AdjClose"),provider="yahoo", 
  origin="1970-01-01",compression="m", retclass="zoo")

另一方面的市盈率資料,之前為了自己弄的Excel模型就有找過。可以用恆指公司網頁上的.xls檔案。因為在MacOS上沒有再找處理excel格式的套件,所以下載回來後,我先刪去了合併儲存格的大標題、改了日期格式、和另存成我熟悉的csv檔案。

這兩項數據有不同的日期表示方式,Yahoo用的是每月首個交易日,恆指公司用的卻是每月最後一日。所以先將兩項資料都用"zoo"格式的as.yearmon(index( )) 去轉換成配合這類月度資料的時間序列。將兩個數據合併,然後在所有數據中,再抽出所想要的時間片段。而與他的例子不同的是,我選擇了1987年1月至2016年5月的資料。

一開始只是計算某一個市盈率範圍在某個時間後的表現,這個可以比較簡單可以做到。然後就想要引伸到不同情況(5種市盈率範圍、5種觀察時期),還有要把每個結果整合到一個表格中來呈現,就只想到用nested-loop的方式去計算每一個數值,然後逐步組合成用於表達的Matrix。不過,其實這方法在R的世界中好像因為執行效率的考慮而儘量避免的,會比較推崇的是Vectorization,把數據一開始便弄成更多維度的矩陣去運算。

整個結果如下圖。

2016年5月21日 星期六

Edx - TW3421x Credit Risk Management

Edx 上看到一個Credit Risk Management的課堂,報了打算讓自己溫習一下從前上課所學。最近這快要完成了,來總結這課堂所學的內容。

這課堂由Delft University of Technology的Dr. Pasquale Cirillo 講授。說話速度像是刻意放慢了,講解不會沉悶之餘,初時還有用RSA動畫的方式去解釋事情之間關係。內容方面,沒有涉及複雜的數學證明,某些公式出現時就重申:推導過程不在課程以內,然後直接使用。這令課程變得簡單之餘,也清晰了這是集中在讓初學者理解概念。
The computation of WCDR is performed using the formula you see on your screen. I do agree with you if you think that this formula has somehow fallen from the sky.
That's true: in this course this formula has fallen from the sky. The point is that, in order to derive this formula completely and formally, we would need - all - a big probabilistic apparatus that we do not have, such as for example the copula model. So, that's it: just take this formula for granted.
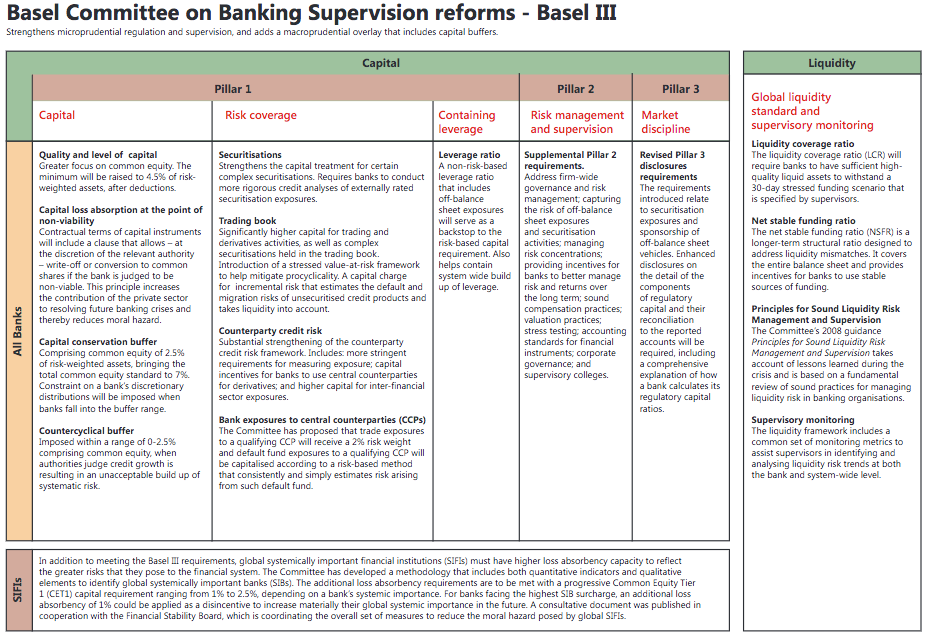
課程把信用風險放在從巴塞爾協定中開始講起。巴塞爾協定是對銀行業的其中一項重要條約。從巴塞爾協定二起,基本定立出三條支柱。
1) Minimum Capital Requirement (Credit Risk, Market Risk, Operational Risk)
2) Supervisory Review Process
3) Market Discipline

更仔細的在:http://www.bis.org/bcbs/basel3/b3summarytable.pdf